华体会科技有限公司_华体会体育官方网站_华体会HTH数据服务

服务热线:
021-64225052

资讯动态
News
分类>>机器学习模型如何处理赛事数据?从数据清洗到结果建模
 2026-11-15 12:54:03
 浏览次数: 次
 返回列表
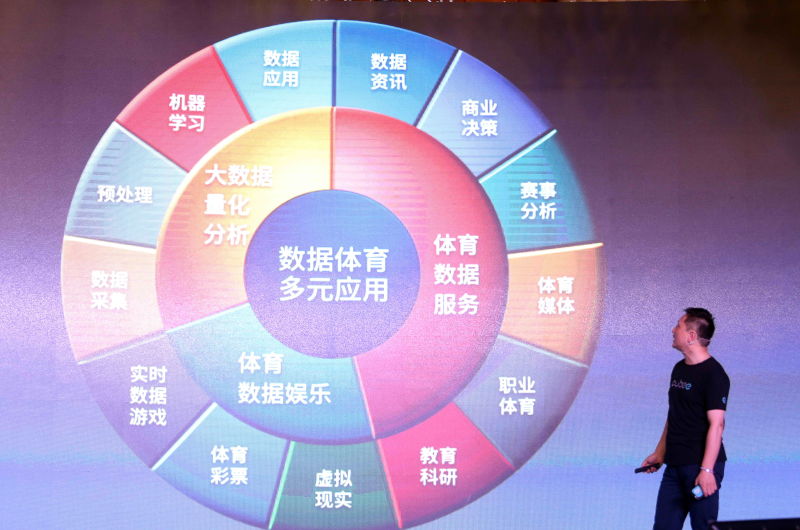
足球比赛的数据记录越来越细致。一场比赛可能包含数千个事件,如传球、抢断、射门和跑位。这些原始记录并不能直接用来分析,需要经过系统处理。
机器学习模型在其中承担的任务,是将这些杂乱的数据转化为可计算、可比较的数值特征,并在此基础上建立模型,观察数据之间的稳定关系。
赛事数据通常来自专业的数据采集系统。采集到的原始事件流包含时间、坐标、动作类型和结果标签。这些数据存在一些常见问题:同一动作可能被重复记录,不同来源对同一动作的定义并不统一,部分字段缺失。如果直接使用原始数据,模型可能学到错误模式。
清洗阶段主要做四件事:删除重复记录,修正坐标异常(例如球员位置超出场地边界),统一事件命名,推断或填补缺失信息。经过清洗的数据才能进入下一步。清洗过程并不复杂,但直接影响后续所有环节的质量。
清洗后的数据仍然是离散事件序列,需要转化为机器学习模型能够处理的数值特征。特征提取的目标是从原始事件中提炼出对比赛走势有区分度的信息。
1. 传球网络指标。把球员看作节点,传球看作连接,可以计算球队的传球密度、进攻区域内的传球次数。这类指标能反映球队的整体组织方式。
2. 射门质量指标。单纯统计射门次数会忽略射门位置和难度。预期进华体会股份有限公司球数值是常用替代,它综合了射门位置、角度、防守压力等因素,对射门机会进行量化。
3. 比赛状态指标。比分差距、剩余时间、人数对比等状态会影响球队行为。通常将比赛切分为固定时间段,统计每个时间段内的事件数量,并加入该时间段开始时的比分和人数信息。
4. 球员行为统计。包括传球成功率、抢断位置、跑动覆盖区域等。这类数据经过标准化后作为补充特征。
特征选择时,会评估每个特征与目标之间的相关性,保留信息量较高的部分。在比赛结果分析中,预期进球差值、传球网络效率、对方半场传球成功率等特征通常具有较高参考价值。
根据分析目标不同,模型结构有所区别。如果目标是判断比赛走向,常用的是分类模型,例如梯度提升树或逻辑回归。这类模型接受固定长度的特征向量,输出各类别的概率。训练数据通常选取过去几个赛季的联赛记录,按时间顺序划分训练集和验证集。
如果目标是分析事件序列,例如一段时间内发生进球的可能性,则更适合使用序列模型。循环神经网络和 Transformer 架构能够处理事件之间的时序依赖关系。这类W LB模型输入的是事件序列,输出与时间相关的概率。
模型训练过程中需要注意类别不平衡问题,因为某些结果出现频率较低。评估模型时,除了准确率,还需要观察概率校准情况,确保输出的概率与实际频率一致。
计算每个特征对某次结果的贡献大小。例如,某场比赛某一方优势明显,可以查看是哪些特征起了主要作用,如对方防线传球效率偏低、本队预期进球差值较高等。这为分析人员提供了可检查的依据。
将模型应用到不同赛季或不同联赛的数据上,观察性能是否稳定。如果性能明显下降,说明模型可能学到了特定赛季或联赛的特殊模式,需要调整特征或重新训练。
将机器学习模型的结果与简单统计模型进行比较。长期来看,机器学习模型在部分场景下能捕捉到更复杂的交互关系,但在另一些场景中与简单模型差异不大。这种对照有助于明确模型的适用条件。
从数据清洗到结果建模,每个环节都包含对足球比赛结构的假设。特征选择决定了模型能看到什么,时间划分决定了模型能学到什么,训练数据范围决定了模型能迁移到哪里。机器学习处理赛事数据不是寻找一个固定答案,而是构建一条可重复、可检查的分析流程。理解这个流程,有助于区分数据支持的判断和主观印象。返回搜狐,查看更多